SAP a Google Cloud: De Datos Bloqueados a Business Intelligence e IA con BigQuery
Por qué trasladar máquinas virtuales a la nube no resuelve el estancamiento analítico. Descubre cómo extraer el dato crudo de SAP a BigQuery, gobernar transformaciones con Dataform y habilitar IA de negocio verificable sin alucinaciones.
El Síndrome del Dashboard Olvidado: Por Qué la Analítica Tradicional de SAP Falla en Producción
En el 90% de las corporaciones que auditamos tras ejecutar un proyecto de migración de SAP a Google Cloud, se repite exactamente la misma paradoja: la infraestructura técnica se traslada con éxito a máquinas Compute Engine certificadas para SAP HANA, los SLAs de disponibilidad alcanzan el 99.99%, pero el comité de dirección sigue esperando dos semanas para responder a una pregunta básica sobre márgenes de beneficio o rentabilidad por cliente.
El resultado directo de esta frustración es lo que en arquitectura denominamos el "Síndrome del Dashboard Olvidado": paneles en herramientas de Business Intelligence tradicionales repletos de gráficos complejos que consumieron meses de desarrollo pero que nadie en el equipo ejecutivo consulta. La causa raíz no radica en el visualizador, sino en la rigidez del modelo subyacente. Si para modificar una agregación o cruzar un dato de ventas con logística se requiere abrir un ticket de consultoría SAP de tres semanas, el directivo abandona el panel y regresa a pedir un extracto manual a Excel.
Dashboards que Nadie Utiliza y Latencia de Decisión
Cuando los datos transaccionales permanecen atrapados en tablas monolíticas o silos departamentales, la latencia de decisión paraliza a la empresa. Para revertir esta situación y dotar al negocio de autonomía real, las organizaciones líderes están sustituyendo reportes estáticos por agentes de IA sobre BigQuery para transformar dashboards estáticos en Business Intelligence interactivo. Sin embargo, para que un agente o un analista pueda generar valor, el dato debe residir en un motor analítico sin fricciones.
La Trampa de la IA Generalista Desconectada del Core de Negocio
El segundo síntoma recurrente es el intento desesperado de "ponerle IA" a la empresa. Los equipos directivos escuchan hablar del potencial de los modelos de lenguaje y contratan licencias de chatbots generalistas, esperando que hagan magia conectándose a sus datos.
El desenlace es siempre el mismo: alucinaciones inaceptables y desconfianza inmediata. Un modelo generalista desconectado del contexto semántico de SAP no comprende qué significa un campo VBELN, qué estatus fiscal define una venta cerrada en VBRK, ni cómo calcular el margen bruto deducidas las devoluciones. La inteligencia artificial empresarial solo funciona cuando está respaldada por una fuente de verdad única y estructurada en Google Cloud.
Matriz Arquitectónica: Hosting Tradicional (IaaS) vs. Modernización Analítica con BigQuery
La mayoría de los integradores de sistemas abordan la migración de SAP exclusivamente como un ejercicio de cambio de centros de datos (Lift & Shift de servidores). En la siguiente tabla técnica contrastamos ese enfoque reactivo frente a la arquitectura de modernización de datos centrada en BigQuery:
| Dimensión Arquitectónica | Hosting Tradicional (Lift & Shift IaaS) | Modernización Analítica con BigQuery |
|---|---|---|
| Objetivo Primario | Mover VMs de SAP a Compute Engine para ahorrar en hardware. | Desbloquear los datos crudos para Business Intelligence e IA directiva. |
| Capa de Almacenamiento | Base de datos transaccional SAP HANA monolítica. | BigQuery Serverless Columnar Data Warehouse (Medallion). |
| Latencia de Consultas BI | Minutos u horas (bloquea recursos de la base de datos operativa). | Subsegundo a pocos segundos sobre miles de millones de registros. |
| Gobierno y CI/CD | Configuraciones manuales en SAP GUI / scripts dispersos. | Repositorios de código versionado en Git con Dataform (SQLX). |
| Habilitación de IA | Imposible o limitada a chatbots que alucinan sin contexto. | Agentes verificables con Gemini y vistas semánticas precisas. |
| Impacto FinOps | Costes fijos altos por sobredimensionamiento de máquinas virtuales. | Almacenamiento activo a bajo coste ($0.02/GB) y slot autoscaling. |
Demostración en Vídeo: Arquitectura End-to-End de SAP a BigQuery
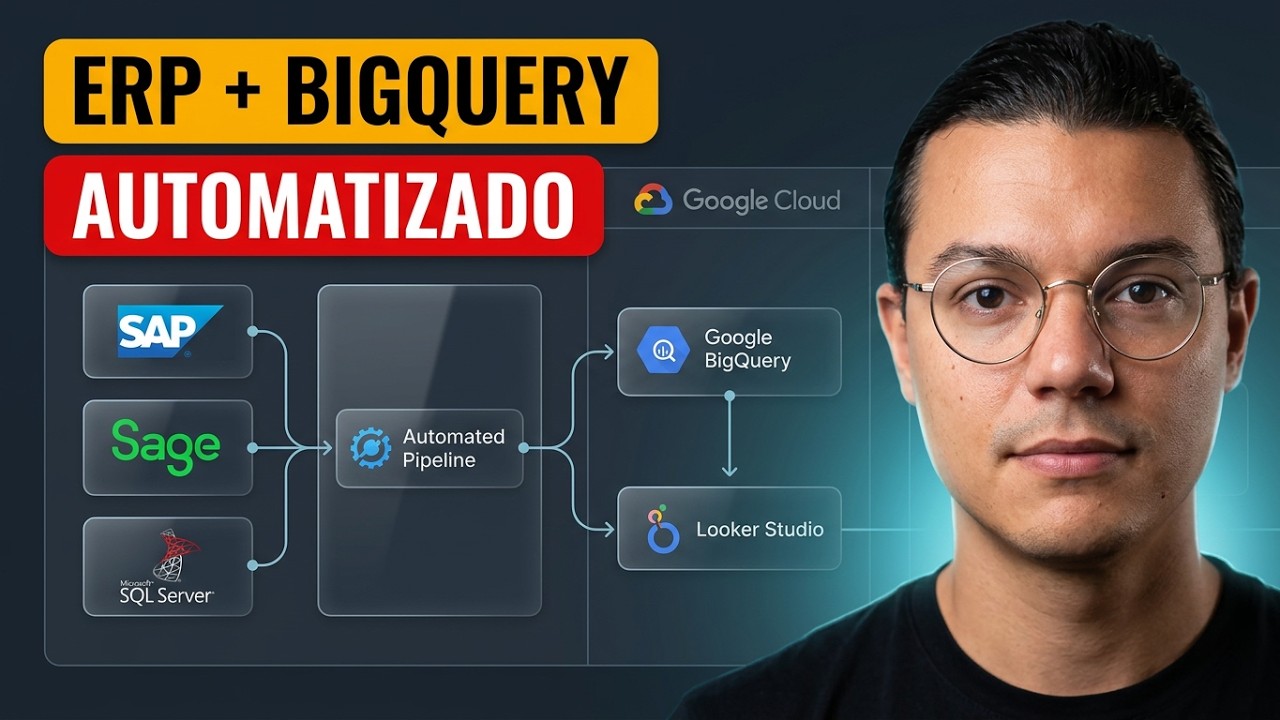
En esta masterclass técnica, Eduardo Martínez Agrelo detalla paso a paso la arquitectura de referencia para conectar los datos de negocio de tu ERP con Google Cloud, evitando los cuellos de botella de infraestructura y activando una capa analítica moderna:
Antipatrones Críticos en la Migración de SAP: Los 5 Errores Más Caros en Producción
A lo largo de múltiples auditorías en entornos de producción, hemos identificado 5 decisiones erróneas que destruyen el retorno de inversión de la nube y perpetúan la ineficiencia analítica:
Antipatrón 1: Traer Modelos Preagregados de SAP/BW en Vez de Datos Crudos
El error más extendido consiste en exportar cubos analíticos prefabricados de SAP Business Warehouse (BW). Cuando exportas un cubo preagregado, destruyes la granularidad transaccional. Si el negocio mañana necesita analizar el ticket promedio por línea de factura o el comportamiento a nivel de SKU por cliente, el cubo es incapaz de responder.
Decisión de Staff Architect: Extrae siempre el dato crudo transaccional atómico (tablas como VBAK, VBAP, BKPF, BSEG) directamente a la capa Bronze de BigQuery. Deja que la capacidad de procesamiento paralelo masivo (MPP) de BigQuery ejecute las agregaciones en microsegundos según cambie la necesidad del negocio.
Antipatrón 2: Mantener Nombres de Campos Crípticos sin Capa Semántica
Exponer tablas directamente al usuario final o a un LLM con columnas como KUNNR (Cliente), MATNR (Material), WAERK (Moneda) o NETWR (Importe Neto) garantiza el fracaso del proyecto. Ni los analistas de negocio comprenden la nomenclatura alemana de SAP de los años 80, ni los modelos de IA pueden generar consultas SQL precisas sin equivocarse en los cálculos. Es obligatorio crear una capa semántica Silver que traduzca y estandarice estos identificadores.
Antipatrón 3: Ingestas Totales Diarias (Full Load) en Lugar de CDC Incremental
Ingestar a diario tablas completas de 200 millones de filas desde SAP no solo satura el ancho de banda de red (Cloud Interconnect / VPN) y ralentiza el ERP productivo, sino que dispara exponencialmente los costes de cómputo en BigQuery. Implementa siempre captura de datos modificados (CDC) o ingestas incrementales particionadas por fecha de actualización (ERDAT / AEDAT) para transferir y procesar exclusivamente los registros creados o alterados en las últimas 24 horas.
Antipatrón 4: Transformaciones Dispersas sin Dataform ni Control de Versiones
Cuando las transformaciones de datos viven en vistas sueltas creadas a mano en la consola de BigQuery o en notebooks de Jupyter locales, la gobernanza empresarial es inexistente. Si un ingeniero borra una vista o altera una fórmula, el reporting financiero se rompe sin rastro de auditoría. Para garantizar control de versiones, linaje y pruebas automáticas de datos, debes implementar una arquitectura ELT moderna con Dataform, SQLX incremental y CI/CD en Google Cloud.
Antipatrón 5: Monolito sin Segregación de Entornos (Dev, Staging, Prod)
Ejecutar consultas de desarrollo sobre el mismo proyecto de Google Cloud donde reside el reporting productivo de la empresa es una receta para el desastre: riesgos de seguridad graves, degradación de cuotas de cómputo y riesgo de mutación accidental de datos. Una arquitectura madura aísla físicamente los entornos mediante proyectos GCP separados gobernados por IAM de mínimo privilegio.
Implementación Técnica: Pipeline de Ingesta, Modelado con Dataform y Separación de Entornos
Para estructurar los datos procedentes de SAP en BigQuery con calidad empresarial, aplicamos el patrón de arquitectura Medallion:
- Capa Bronze (Raw): Tablas crudas sincronizadas desde SAP (ej.
raw_sap.vbakyraw_sap.vbap) en proyectos segregados de ingesta. - Capa Silver (Staging / Curated): Limpieza, casting de tipos de datos, resolución de nulos y renombramiento de nombres técnicos alemanes a términos de negocio legibles.
- Capa Gold (Marts): Modelos analíticos en estrella o vistas agregadas optimizadas para reporting directivo y consumo por agentes inteligentes.
Código Dataform (SQLX): Transformación Incremental y Assertions
A continuación, presentamos un modelo SQLX de producción para Dataform que transforma las cabeceras de pedidos de venta (VBAK), renombra campos técnicos, aplica particionamiento diario y define reglas automáticas de calidad (assertions) para impedir que registros corruptos lleguen a producción:
config {
  type: "incremental",
  schema: "silver_sap",
  name: "sales_orders_header",
  description: "Capa Silver: Pedidos de venta depurados procedentes de SAP VBAK",
  tags: ["sap", "silver", "daily"],
  bigquery: {
    partitionBy: "creation_date",
    clusterBy: ["customer_id", "sales_org"]
  },
  assertions: {
    uniqueKey: ["order_id"],
    nonNull: ["order_id", "customer_id", "creation_date", "net_amount"]
  }
}

-- Definición de la transformación con renombramiento semántico
SELECT
  TRIM(VBELN) AS order_id,
  PARSE_DATE('%Y%m%d', ERDAT) AS creation_date,
  TRIM(ERNAM) AS created_by_user,
  TRIM(VKORG) AS sales_org,
  TRIM(VTWEG) AS distribution_channel,
  TRIM(KUNNR) AS customer_id,
  SAFE_CAST(NETWR AS NUMERIC) AS net_amount,
  TRIM(WAERK) AS currency,
  CURRENT_TIMESTAMP() AS ingested_at
FROM
  ${ref("raw_sap", "vbak")}

-- Lógica incremental para optimizar costes FinOps y procesar solo delta
${when(incremental(), `
  WHERE PARSE_DATE('%Y%m%d', ERDAT) >= DATE_SUB(CURRENT_DATE(), INTERVAL 3 DAY)
`)}
Gracias a la modularidad de Dataform, el archivo workflow_settings.yaml permite desplegar este pipeline en entornos dev-project, staging-project y prod-project sin modificar una sola línea de código SQLX, garantizando que los datos de prueba nunca contaminen el Data Warehouse directivo.
Activación de IA de Negocio: Conectar Agentes Verificables al Core de SAP
Una vez que los datos de SAP están limpios, documentados y centralizados en BigQuery, la inteligencia artificial deja de ser un juguete que alucina para convertirse en un motor estratégico de ventaja competitiva.
Al aplicar una arquitectura de automatización del análisis y eliminación de cuellos de botella con agentes de datos sobre BigQuery, el modelo de lenguaje actúa únicamente como intérprete semántico. Cuando un director financiero pregunta: «¿Cuáles son los 5 clientes con mayor volumen de facturación este trimestre y qué porcentaje de margen representan frente al mismo periodo del año anterior?», el sistema opera con garantías matemáticas:
- Traducción Determinista: El agente traduce la consulta natural a SQL validado contra las tablas de la capa Gold de Dataform.
- Ejecución en Motor Analítico: BigQuery ejecuta el cálculo en milisegundos con total precisión numérica.
- Respuestas Explicables: La respuesta devuelta al directivo incluye la cifra exacta y el código SQL ejecutado, permitiendo una trazabilidad y auditoría total.
Para equipos departamentales que buscan eliminar la dependencia técnica de hojas de cálculo aisladas, también es posible adoptar estrategias de modernización de datos con BigQuery Conversational Analytics para consultar métricas en lenguaje natural sin necesidad de escribir código.
Preguntas Frecuentes Técnicas (FAQ)
¿Cómo se extraen los datos de SAP hacia BigQuery sin impactar el rendimiento transaccional?
Se utilizan conectores nativos y certificados como BigQuery Connector for SAP o herramientas de replicación CDC (Change Data Capture) basadas en logs (como Google Cloud Datastream o SAP Landscape Transformation - SLT). Estas soluciones leen los deltas de las tablas transaccionales en streaming o micro-batch sin bloquear registros ni saturar la memoria de la base de datos operativa HANA.
¿Por qué es un error migrar los cubos de SAP BW en lugar de las tablas crudas?
Los cubos de SAP BW consolidan agregaciones rígidas diseñadas hace años para compensar la lentitud de los discos antiguos. Al importar un cubo en lugar de las tablas atómicas crudas, pierdes la posibilidad de recalcular dimensiones, cruzar datos con orígenes modernos (CRM, Google Ads, IoT) o entrenar modelos de Machine Learning con datos transaccionales detallados.
¿Cómo garantiza Dataform la separación entre desarrollo, pruebas y producción en GCP?
Dataform desacopla el código SQLX del entorno de ejecución mediante configuraciones de compilación. A través de ramas de Git y entornos definidos en workflow_settings.yaml, el mismo repositorio compila las consultas apuntando dinámicamente a los datasets y proyectos GCP de Dev, Staging o Prod, garantizando despliegues seguros vía CI/CD.